Agent面试十连问(上):大厂必考的架构、记忆、工具安全,一次讲透
- 2026-10-05 01:26:16
现在大厂面试Agent,面试官根本不听你吹模型有多聪明,他们只关心系统有多稳定。
这篇把字节跳动Agent面试的工程落地方案十连问的前5问打包讲透:从系统架构设计,到规划执行闭环,到记忆分级,到向量数据库选型,再到工具调用安全。下篇讲RAG优化和性能高可用。
第一问:生产级Agent系统架构怎么设计?
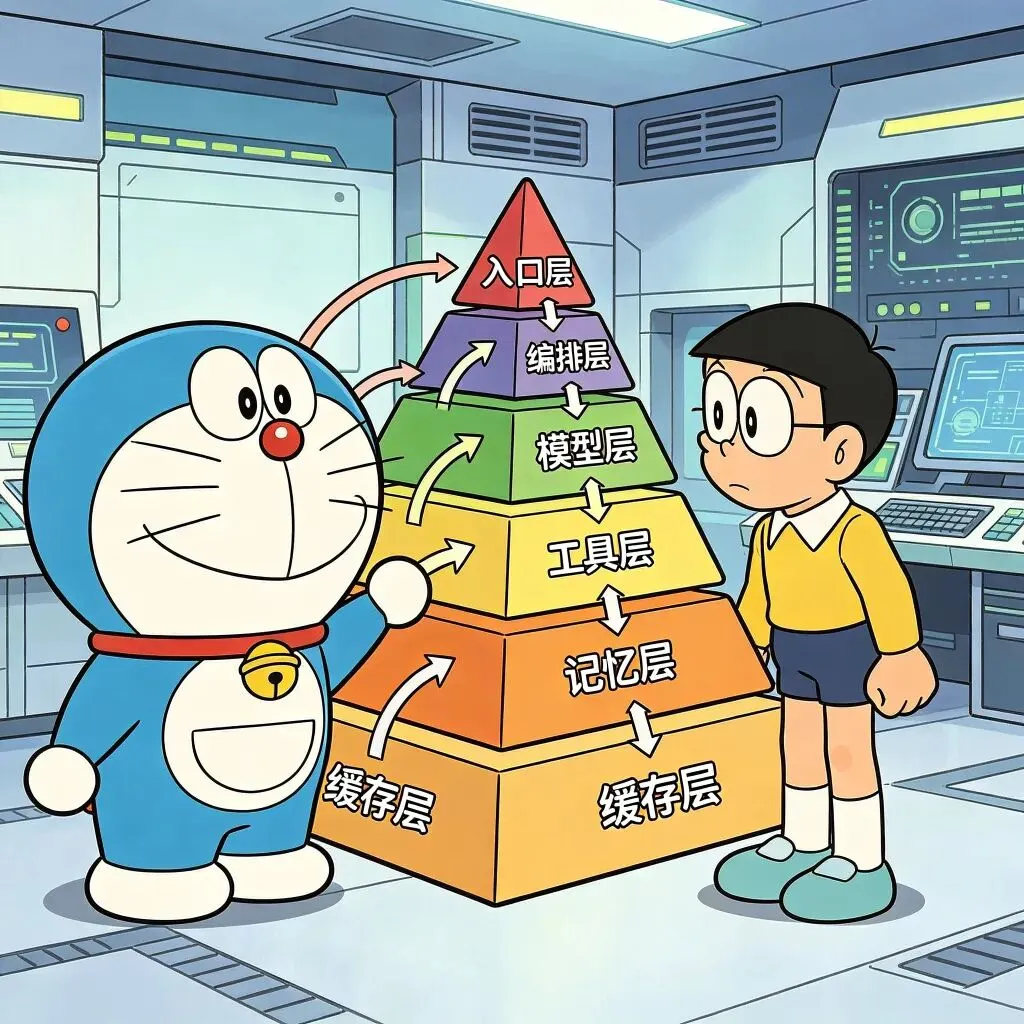
Agent六层架构:入口层→编排层→模型层→工具层→记忆层→缓存层
千万别一上来就凭印象画框图。面试官想听的是你对系统能力的逻辑切分和解耦能力。核心是把Agent拆成6个层级:
1.入口层(网关):像机场安检,认证、限流、路由到对应会话。
2.编排层(Planner):把模糊意图拆解成具体可执行的子任务。
3.模型层:负责动脑子做决策,是Agent的"大脑"。
4.工具层:跟外部环境交互,查数据库、调API。
5.记忆层:实时读写上下文,让Agent"记得住"。
6.缓存层:高频热数据缓存,减少重复计算。
完整流程:入口网关安检→Planner拆解任务→Executor调度模型和工具→记忆层读写→缓存层加速→安全模块审核→聚合器拼成流畅的人话返回。
agent_system/├── gateway/# 入口层:认证、限流、路由├── orchestrator/# 编排层:planner规划+executor执行+reflector反思├── model/# 模型层:大模型调用+大小模型路由├── tools/# 工具层:工具注册+schema校验+实现├── memory/# 记忆层:短期/摘要/长期/业务库├── cache/# 缓存层:Redis热数据缓存└── security/# 安全模块:输入输出过滤
第二问:规划执行反思闭环怎么实现?
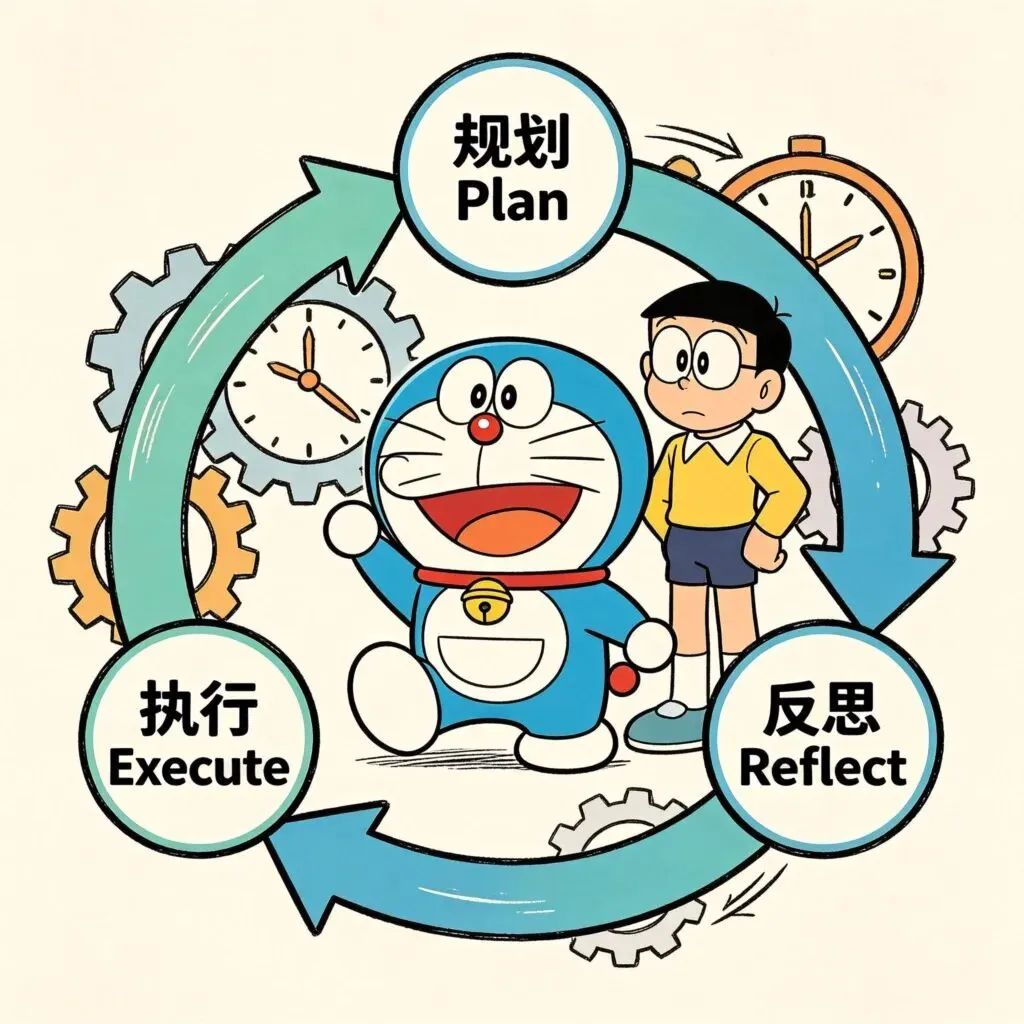
规划→执行→反思→重规划,状态机驱动的闭环
这道题表面问概念,工程落地里考的是状态机控制。想象成打车用导航:
第一步 Planner规划:不仅生成执行步骤,还给每一步定好验收标准。就像导航先选路线,预估每段路多久。
第二步 Executor执行:按步骤调度工具和模型,像司机踩油门按导航开车。
第三步 Reflector反思:拿到工具结果做校验。如果不对,带着报错原因跑回去让Planner重新规划。
必须加三道保险:最大重试轮次(防死循环)、单次执行超时(防卡死)、最终人工兜底(重试耗尽后降级)。不加这三道锁,模型死磕错误工具会把Token瞬间打爆。
class AgentLoop:def __init__(self, max_retries=5, timeout=120):self.max_retries = max_retries# 保险1self.timeout = timeout# 保险2def run(self, query):state = ”PLANNING”while state not in (”DONE”, ”FAILED”):if state == ”PLANNING”:plan = self.planner.plan(query)# 含验收标准state = ”EXECUTING”elif state == ”EXECUTING”:result = self.executor.execute(plan, timeout=self.timeout)state = ”REFLECTING”elif state == ”REFLECTING”:if self.reflector.check(result, plan.acceptance):state = ”DONE”elif self.retry_count < self.max_retries:query = self.reflector.feedback(result, query)state = ”PLANNING”# 带报错重规划else:return self.fallback_response()# 保险3:兜底return result.answer
第三问:多轮对话记忆分级和缓存策略?
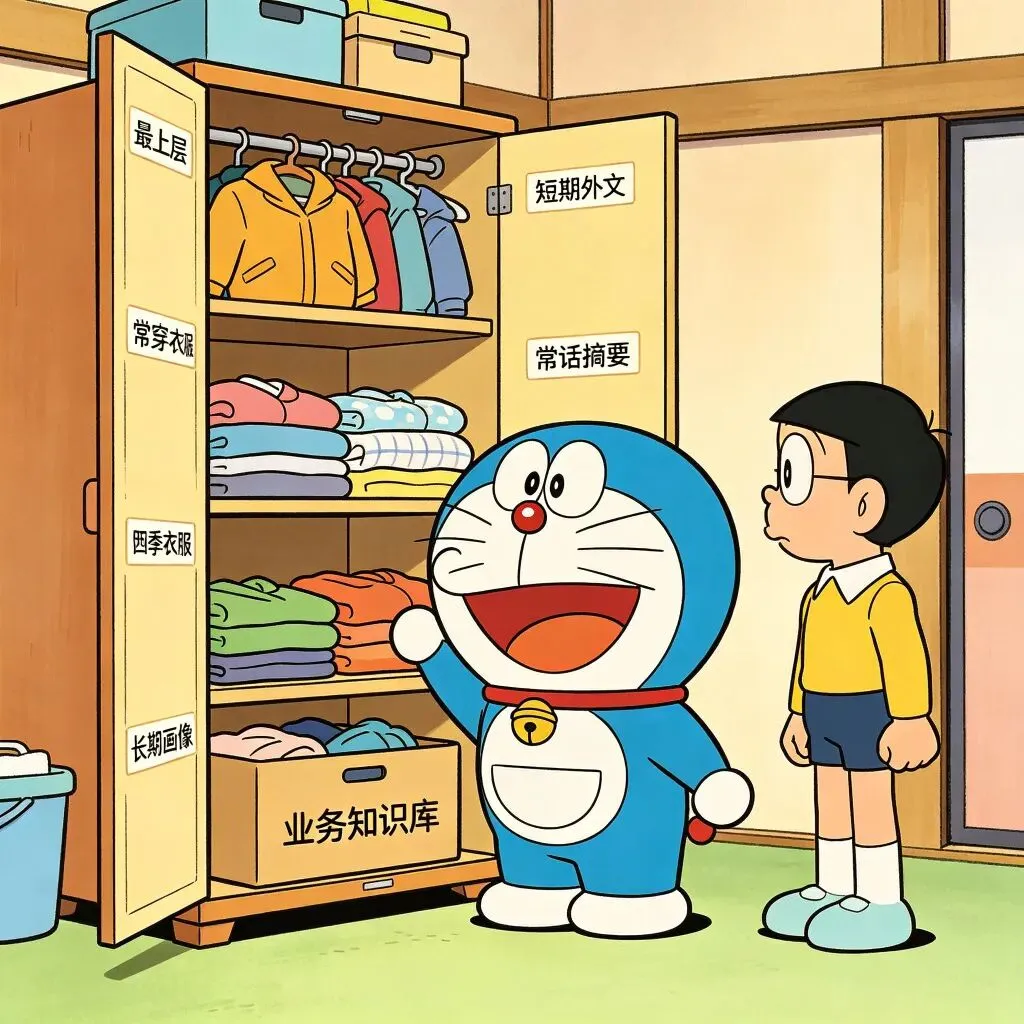
四层记忆体系:短期上下文→会话摘要→长期画像→业务知识库
记忆不是越长越好,而是越有条理越好。管理记忆就像整理衣柜,分4层:
第一层 短期上下文:随手拿的外套,存Redis做会话级热缓存,最近几轮原始消息,拿起来最快。
第二层 会话摘要:最常穿的衣服,对话变长后动态压缩,只保留聊天主线。
第三层 用户长期画像:换季才翻的衣服,放线上数据库,需要时语义召回(偏好、历史订单、常用地址)。
第四层 业务知识库:压箱底的经典款,扣款记录、订单状态等强一致性数据必须进业务DB。
缓存key必须把用户ID+会话ID+工具ID+参数哈希拼在一起,每个key带TTL和版本号。黄金定律:缓存乱了比没有缓存更可怕,宁可不加缓存也不能让不一致数据污染上下文。
第四问:向量数据库怎么选?淘宝级场景怎么落地?
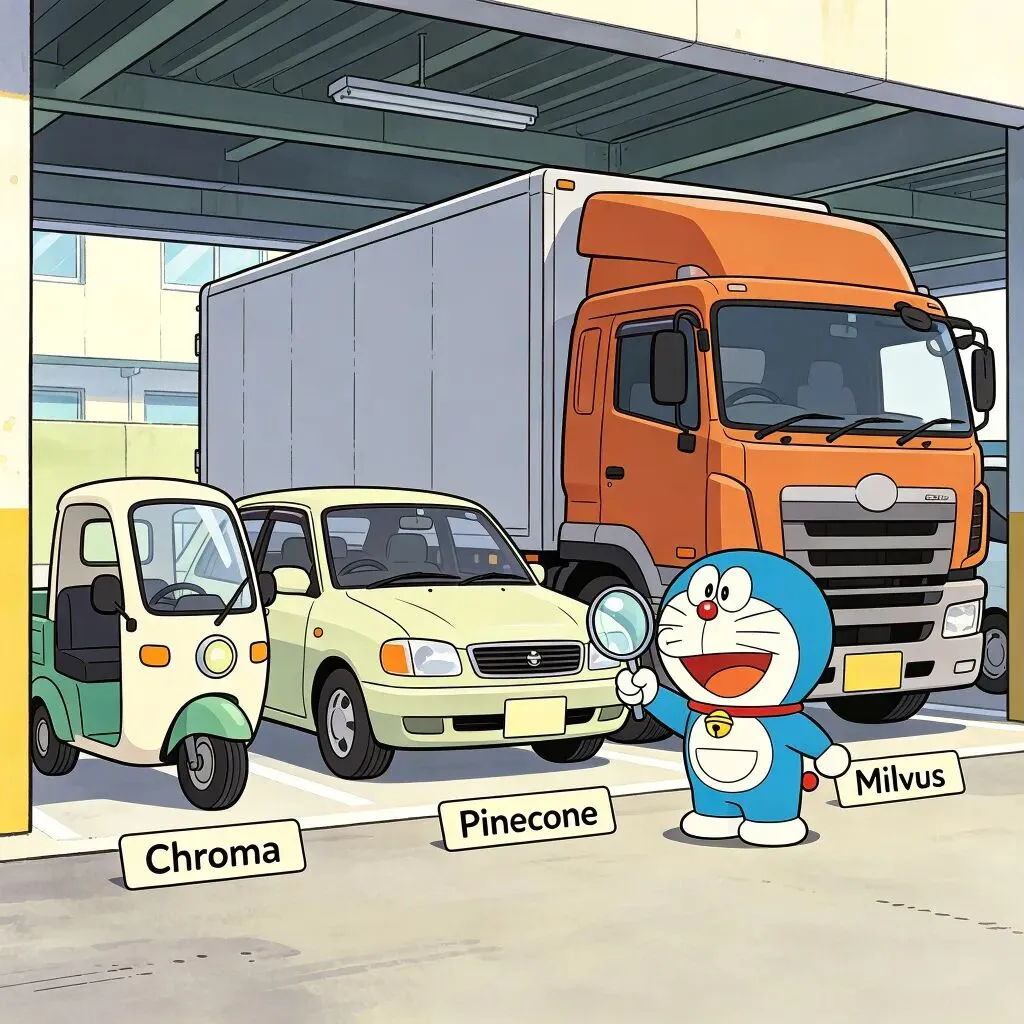
向量数据库三选一:轻量原型 vs 全托管SaaS vs 云原生自建
选型不能只选最贵的,要选最合适的——场景决定技术栈。三款主流对比:
淘宝级场景(亿级数据+权限复杂+实时交易链路)必须选Milvus或自研。而且纯向量相似度不够,必须融合类目、价格、品牌等业务字段做过滤,检索才精准。
第五问:工具调用的可信保障怎么做?
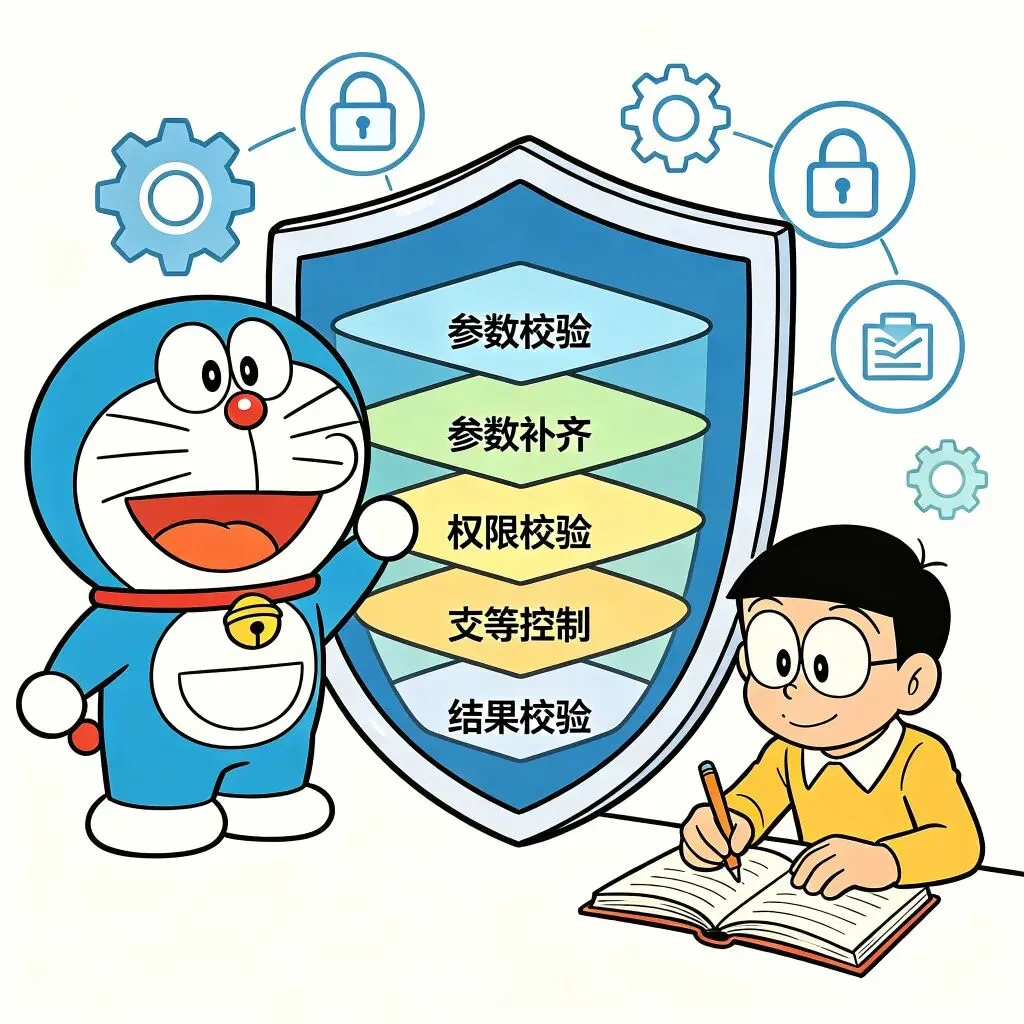
五层防护+四步熔断,给Agent的工具调用穿上防弹衣
让大模型调工具就像让刚入职的实习生干活,必须给它穿上五层防弹衣:
Schema校验:参数格式对不对 参数补齐:缺省值自动填补 权限校验:不越权调敏感API 幂等控制:防重复下单/扣款 结果校验:返回数据合不合逻辑
模型反复调错同一工具时,四步熔断:①连续两次出错拉入黑名单 ②强制切断让Planner重规划 ③还不行就规则化兜底输出预设话术 ④核心交易链路直接转人工。宁可降级转人工,也不让模型死磕浪费Token。
上篇答题框架速查
下篇讲工具description写法、RAG切分与检索优化、延迟优化与弹性伸缩,敬请关注。

